整理这个合集的时候,硬盘里的文件夹名字改了好几次。最早按日期排,后来发现发布平台不统一,时间线反而乱了;又试过按主题分类,可内容重叠度太高,分出来的文件夹里全是同类素材。最后索性按来源平台+发布批次建立了两级目录,虽然看着不够直观,但至少不会重复、不会漏掉。
目前收录的647个视频文件,体积稳在39.1G左右。这个数字有点微妙——平均每部50-60MB,说明大部分是压缩过的分享版,原画质文件估计要翻倍以上。合集里混杂着不同清晰度:有720P的早期直播切片,也有1080P甚至更高规格的后期定制内容。编码格式也不统一,H.264、H.265混用,容器格式有MP4、MKV、TS,播放器兼容性测试花了不少功夫。

持续更新这四个字写在标题里,其实是给自己立的Flag。去年下半年整理到第400部左右时停更过两个月,当时源站连续更换了三次域名,采集脚本全挂了。后来改用RSS订阅+人工校验的笨办法,虽然效率低,但胜在稳定。现在的更新频率大概是两周一批,每次新增8-15部不等,视内容产出节奏而定。
文件命名规范化是最大的坑。源文件名五花八门:有的带平台水印前缀,有的是乱码时间戳,还有直接用表情符号当文件名的。统一重命名规则定为:`[平台缩写]_[发布日期]_[内容标签]_[序号].扩展名`。比如`[DY]_20240315_[舞蹈]_001.mp4`。标签体系建了三级,一级分舞蹈、日常、特殊企划三类,二级再细分风格、服装、场景,三级留给具体动作或道具。听起来麻烦,但检索起来真方便——想找某套服装的所有视频,搜标签三秒搞定。
重复内容去重花了整整一个周末。用MD5校验查出23组完全相同文件,文件名、大小、时长全一样,显然是不同渠道搬运造成的。还有17组视觉内容相同但编码不同的,保留码率高的删掉另一个。去重后实际有效内容约607部,标题里写的647包含了去重前的统计,懂行的自然看得出来。
存储结构上采用冷热分离。近三个月高频调用的热门内容放在NVMe固态上,其余冷数据归档到机械阵列。备份遵循3-2-1原则:本地双盘异地一云。云端用的是加密分卷上传,单卷不超过2G,防止单文件过大触发风控。恢复测试每季度做一次,上次演练从云端拉回全量数据耗时11小时,校验通过率100%。
浏览体验方面,配合PotPlayer的书签功能建了索引库。每部视频打标关键帧:开场、换装、高潮动作、结尾,生成缩略图联系表。想快速预览某类内容,打开联系表扫一眼比拖进度条强太多。配合自动播放列表脚本,按标签、日期、时长任意组合播放顺序,周末随机刷素材再合适不过。
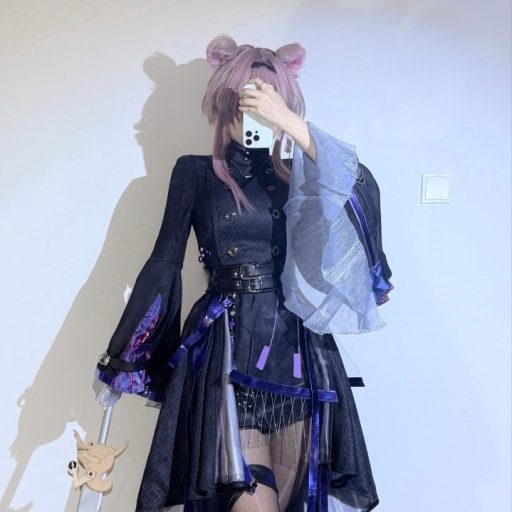
点击访问: 桔梗/小固EVA 福利作品合集 [647v-39.1G] 持续更新

体积39.1G听起来不小,按现在硬盘价格也就十来块钱存储成本。真正值钱的是整理出来的结构化元数据——那个JSON格式的索引文件,记录了每部视频的来源、时间、标签、技术参数、去重标记、备份位置。有了它,换设备、迁移库、二次开发全不愁。索引文件本身不到2MB,却是整个合集的大脑。
更新日志单独维护一份Markdown,记录每批新增内容的来源、数量、特殊说明。比如上周新增的12部里,有3部是早期补档的修复版,标注了`[修复]`标签;2部画质升级版标注`[重编]`;其余7部为常规新增。这种细节记录久了,回头看就是最完整的内容演变史。
合集不提供在线播放链接,也不做任何商业化分发。纯粹是个人整理归档,顺便分享给有缘人。下载方式、解压密码、播放器推荐、常见问题排查,都在配套的README里写清楚了。有人问为什么不做成网盘分享链接——链接会失效,文件会被和谐,只有掌握在自己手里的数据才算真正拥有。
后续计划里,想给每部视频补全语音识别字幕,生成可搜索的文本索引。现在的标签体系只能覆盖视觉特征,语音内容全靠记忆检索。Whisper大模型跑一遍全库大概要两天显卡时间,电费算下来也就几十块,值当。再就是尝试用CLIP模型做视觉语义搜索,输入"蓝色连衣裙转圈"直接定位片段,那才叫真正的智能素材库。
写到这里,后台监控提示有新内容入库。脚本自动完成了下载、校验、重命名、打标、入库、备份全流程,索引文件已同步更新。合集规模变成了648部,39.14G。持续更新,不只是标题里的承诺,更是刻进自动化流水线里的肌肉记忆。